AIサービスによるWebサイトの情報利用を制御するには?robots.txtの新しい動き
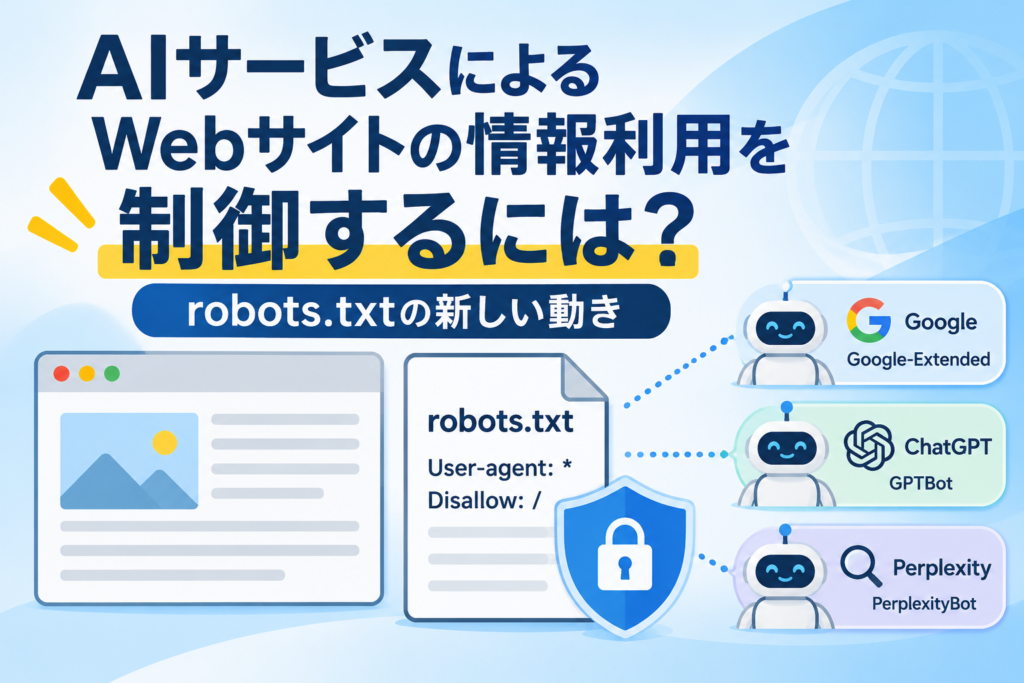
Webサイトに掲載した文章や画像は、検索エンジンだけでなく、生成AIサービスの情報収集にも利用されることがあります。
自社サイトの情報がAIの学習に使われることを避けたい場合、どのような設定ができるのでしょうか。
従来は、AIサービスごとにクローラーを指定してrobots.txtで制御する方法が中心でした。こうした状況に変化をもたらす動きとして、2026年10月30日、Googleが複数のAI事業者に共通する「AI学習の利用設定」をrobots.txtで表現する計画を発表しました。
さらに、11月16日にはIETF(インターネット技術の標準化を進める団体)の関連する技術文書が更新されています。
この記事では、robots.txtによる従来の制御方法と新しい共通設定の仕組み、企業サイトの担当者が今確認しておきたいポイントを解説します。
robots.txtとは?
robots.txtは、Webサイトのルートディレクトリに設置するテキストファイルです。
検索エンジンなどのクローラーに対して、サイト内のどのページを取得してよいか、どのページを取得しないでほしいかを伝えるために使われます。
例えば、次のように記述すると、Googlebotに対してサイト全体のクロールを拒否する意思を示せます。
User-agent: Googlebot
Disallow: /
一方、次の記述では、すべてのクローラーに対してクロールを許可しない方針を示します。
User-agent: *
Disallow: /
ただし、robots.txtはアクセス制限や認証の仕組みではありません。記述を守らないクローラーによるアクセスを強制的に防ぐものではなく、URLを知っている人がページを閲覧することも防げません。
また、robots.txtでクロールを拒否しても、すでに取得された情報や別の場所に転載された情報まで消せるわけではありません。
そのため、非公開にしたい情報を守る目的でrobots.txtだけに頼るのは適切ではありません。
AIによる情報利用と検索エンジンのクロールは別の問題
AIサービスによるWebサイトの情報利用を考えるとき、まず理解しておきたいのが「情報を取得すること」と「取得した情報を何に使うか」は別の問題だという点です。
例えば、AIサービスがWebサイトを訪問する目的には、次のようなものがあります。
- 生成AIモデルの学習に利用するため
- AI検索の回答に使う情報を取得するため
- ユーザーからの質問に応じてページを参照するため
これらは同じ目的ではありません。
AI検索に表示されるための情報取得を許可しながら、モデルの学習には使わないでほしいという方針も考えられます。
そのため、AI関連の設定を行う場合は、クローラーの名前だけでなく、どのサービスのどの用途に影響する設定なのかを確認する必要があります。
従来のAIクローラー制御方法
これまでは、AI事業者ごとに公開されているクローラーの識別名をrobots.txtに記述する方法が使われてきました。
代表的な例として、GoogleとOpenAIの仕組みを紹介します。
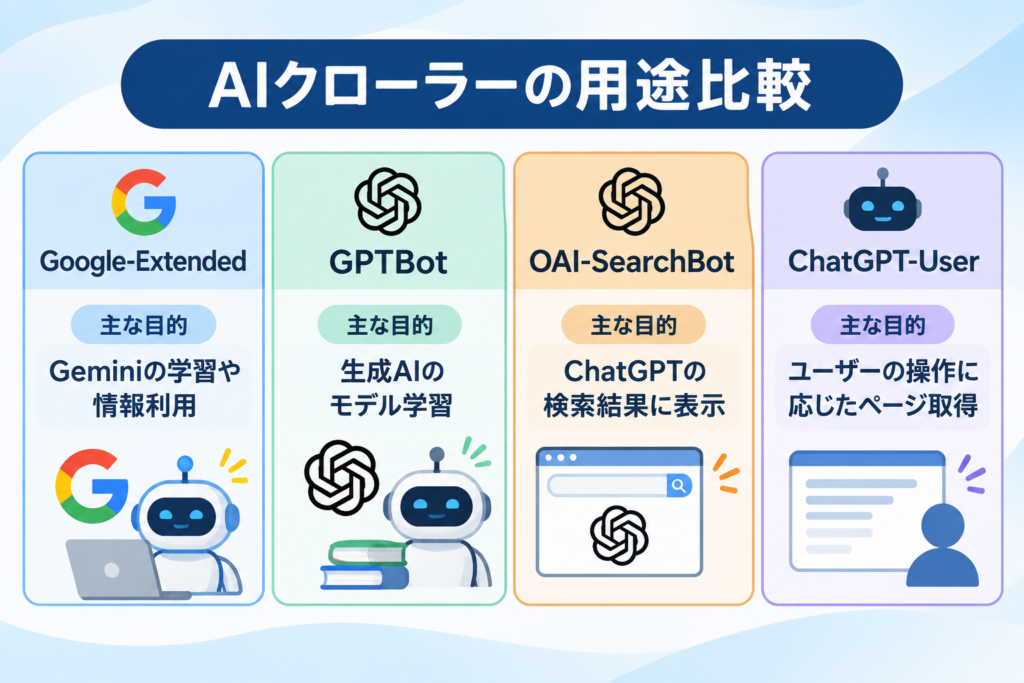
Google-Extended
Googleは、AI関連の情報利用を制御するために「Google-Extended」というトークンを提供しています。
robots.txtには次のように記述します。
User-agent: Google-Extended
Disallow: /
Googleの公式説明によると、Google-Extendedは、Googleが取得したWebサイトの情報をGeminiモデルの将来の学習に使用するかどうかや、Gemini Appsなどで回答の根拠として利用するかどうかに関係する設定です。
重要なのは、Google-Extendedを拒否しても、Google検索への掲載や検索順位には影響しないとGoogleが説明している点です。
また、Google-Extendedは独立したHTTPリクエスト用のUser-Agentではありません。実際の取得には既存のGoogleクローラーが使われ、robots.txt上の制御に専用トークンが利用されます。
OpenAIのクローラー
OpenAIは、用途に応じて複数のクローラーを公開しています。
| クローラー | 主な用途 |
|---|---|
| GPTBot | 生成AIの基盤モデルの学習に利用する可能性がある情報の取得 |
| OAI-SearchBot | ChatGPTの検索機能に表示する情報の取得 |
| ChatGPT-User | ユーザーの操作に応じたページ取得 |
例えば、GPTBotによる取得を拒否する場合は、次のように記述します。
User-agent: GPTBot
Disallow: /
一方、ChatGPTの検索結果には表示される可能性を残し、モデルの学習には利用しないでほしい場合は、GPTBotとOAI-SearchBotを別々に設定できます。
このように、AIサービスごとに用途を分けて制御することが、従来の基本的な考え方です。
複数のAI事業者に共通する新しい設定案
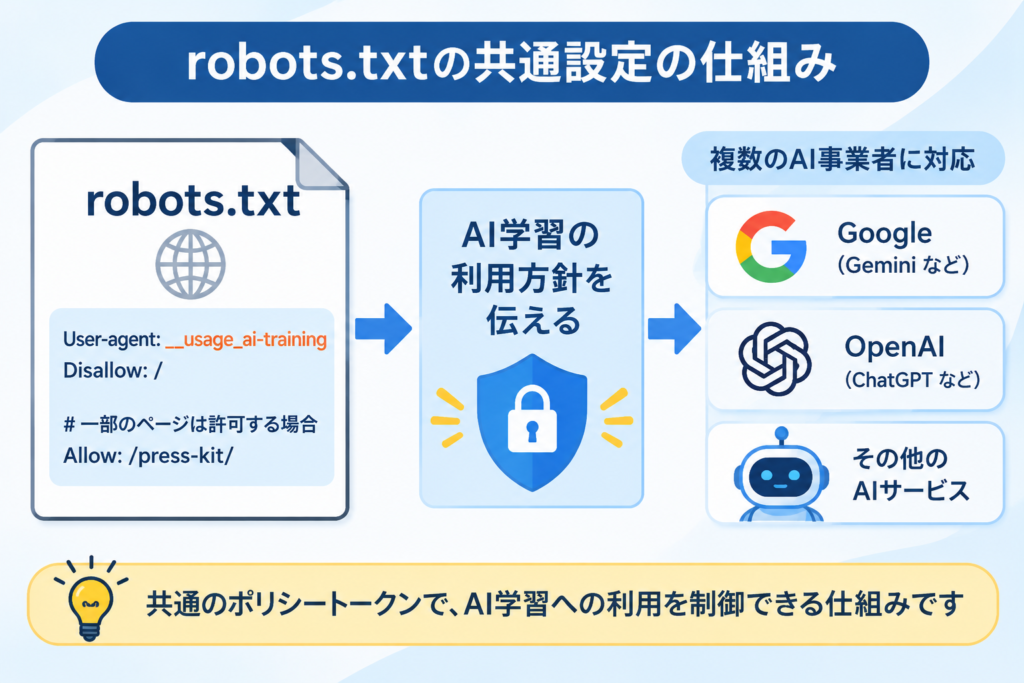
2026年10月30日、Googleは複数のAI事業者が共通して利用できるAI学習の制御方法をrobots.txtに導入する計画を発表しました。
この仕組みは、IETFのAIPREF(AI Preferences)ワーキンググループで進められている検討をもとにしています。
従来は、AI事業者ごとに異なるクローラー名を指定する必要がありました。共通設定が普及すれば、1つの指定で複数の対応事業者にAI学習に関する希望を伝えられるようになります。
共通設定に使われるポリシートークン
2026年11月16日に更新されたInternet-Draftでは、次のポリシートークンが定義されています。
User-agent: __usage_ai-training
Disallow: /__usage_ai-trainingは、生成AIモデルの学習に関する利用方針を表すための共通トークンです。
特定のディレクトリだけを例外として許可したい場合は、次のような記述も提案されています。
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/この例では、原則としてAI学習への利用を望まないものの、/press-kit/以下の情報については許可する意思を表します。
ただし、このトークンは一般的なクローラーのアクセス制御とは別の役割を持ちます。AI学習に関する希望を表すものであり、それ自体がクロールを拒否する命令ではありません。
また、User-agent: *のグループは、この共通トークンに対する指定として扱われません。共通の希望を伝えるには、専用のトークンを明示する必要があります。
まだ正式な標準ではない
ここは特に注意したい点です。
11月16日更新の文書は、IETFのInternet-Draft(標準化に向けた草案)です。IETFが正式に承認したRFCではなく、今後内容が変更される可能性があります。
対応予定についても、事業者ごとに時期が異なります。
- Google:2027年に他のAI事業者とともに対応することを目指すと発表
- OpenAI:今後数か月で共通シグナルを尊重する方針を発表
したがって、現時点でこの共通設定をrobots.txtに追加すれば、すべてのAIサービスで確実に機能するというわけではありません。
導入時期や対応範囲は、各事業者の公式発表を確認する必要があります。
企業サイトで今確認しておきたいこと
新しい共通設定の普及を待つだけでなく、現在利用できる設定やサイトの公開方針を整理しておくことが大切です。
1. 現在のrobots.txtを確認する
まずは、自社サイトのrobots.txtを確認します。
一般的には、次のURLで確認できます。
https://自社ドメイン/robots.txt
Googlebotなどの検索エンジン向け設定に加え、GPTBotやGoogle-Extendedなど、AI関連の指定がすでに存在していないか確認しましょう。
WordPressでは、SEOプラグインやサーバー側の設定によってrobots.txtの内容が管理されている場合もあります。編集する前に、どこで設定されているかを確認してください。
2. AIサービスごとの利用目的を整理する
AIサービスの情報取得を一律に拒否するのではなく、どの用途を許可・拒否したいかを整理します。
例えば、次のような考え方があります。
| 利用目的 | 検討する方針 |
|---|---|
| Google検索への掲載 | 検索流入を重視するならGooglebotを安易に拒否しない |
| Geminiの学習・情報利用 | Google-Extendedの設定を確認する |
| ChatGPTの検索結果への表示 | OAI-SearchBotの設定を確認する |
| OpenAIのモデル学習 | GPTBotの設定を確認する |
AI検索からの流入や情報参照を期待する場合、学習を拒否する設定と検索用クローラーの拒否を混同しないようにしましょう。
3. 公開してよい情報と保護すべき情報を分ける
AIサービスによる情報利用を制御する前に、サイトに掲載している情報そのものを整理することも重要です。
例えば、次のような情報は公開範囲を慎重に判断する必要があります。
- 社内向けの資料や業務マニュアル
- 顧客情報や個人情報
- 契約・取引に関する情報
- 公開を前提としていない画像や文書
これらはrobots.txtで隠すのではなく、認証やアクセス制限など、適切な方法で保護してください。
robots.txtは公開ページの利用方針を伝えるための仕組みであり、機密情報を保護するセキュリティ機能ではありません。
4. 公式情報を定期的に確認する
AI関連のクローラーや利用方針は、今後も変更される可能性があります。
特に共通設定については、標準化の進捗と各AI事業者の対応状況を確認することが大切です。
新しい設定を導入する場合は、対応する事業者、対象となる利用目的、検索表示への影響、既存ルールとの優先関係を確認してから変更しましょう。
まとめ:AIの情報利用方針とクロール設定を分けて考える
AIサービスによるWebサイト情報の利用を制御する方法は、事業者ごとの個別設定から、複数の事業者が共通して利用できる仕組みへと進みつつあります。
2026年11月18日時点では、Google-ExtendedやGPTBotなどの個別設定が利用できる一方、共通の__usage_ai-trainingは標準化に向けた草案段階です。
企業サイトの担当者は、次の点を押さえておきましょう。
- robots.txtはクローラーに対する希望を伝える仕組みであり、アクセス制限ではありません。
- AI学習とAI検索の情報取得は、別々に制御できる場合があります。
- Google-ExtendedやGPTBotなど、事業者ごとの設定を確認します。
- 共通設定はまだ正式な標準ではないため、すぐに全サービスで使えるとは限りません。
- 非公開情報や機密情報は、robots.txtではなく認証・アクセス制限で保護します。
AIによる情報利用をどこまで許可するかは、Webサイトの目的や公開方針によって異なります。検索流入やAIサービスからの参照を考慮しながら、自社に合った運用方針を整理しておくことが大切です。
North River